Contratos de dados: como evitar que o schema quebre pipelines
Uma segunda-feira de manhã, o dashboard de vendas aparece zerado. O pipeline rodou sem erro, mas alguém no time de produto renomeou uma coluna de valor para valor_total na fonte, e ninguém avisou. Esse tipo de quebra silenciosa é o que os contratos de dados existem para evitar. Um contrato define, de forma explícita e versionada, o que um produtor de dados promete entregar e o que os consumidores podem esperar, transformando uma dependência frágil em um acordo verificável.
O termo ganhou tração a partir de 2021, quando o engenheiro Andrew Jones, então na GoCardless, descreveu como formalizar essas promessas para conter mudanças de schema upstream que derrubavam a análise a jusante. Desde então, contratos de dados viraram uma peça central da governança de dados, ao lado de qualidade, catalogação e observabilidade. A ideia é simples de enunciar e trabalhosa de implementar: tratar a interface entre quem produz e quem consome dados com o mesmo rigor que se trata a interface de uma API.
Este guia é prático. Ele mostra o que um contrato de dados especifica, como ele se diferencia de testes, observabilidade e linhagem, onde validá-lo ao longo do pipeline, o que fazer quando um produtor rompe o acordo, e como colocar tudo isso de pé usando ferramentas que a sua empresa provavelmente já tem, sem comprar uma plataforma nova. Um contrato não conserta qualidade de dados sozinho, então o texto também deixa claro onde ele termina e onde as outras práticas começam.
O que é um contrato de dados e o que ele especifica
Um contrato de dados é um documento legível por máquina, normalmente um arquivo YAML ou JSON versionado, que descreve um conjunto de dados como se fosse um produto com garantias. Padrões abertos como o Open Data Contract Standard, mantido pelo projeto Bitol na Linux Foundation, e a Data Contract Specification, mantida de forma independente por Jochen Christ e Simon Harrer, organizam esse documento em seções previsíveis. Ambos convergem no essencial, e um contrato bem escrito cobre os seguintes pontos:
- Schema e estrutura: quais objetos existem, como se organizam e em que servidor ou tabela vivem.
- Nomes e tipos dos campos: cada coluna com seu nome exato e seu tipo lógico (string, número, timestamp), a informação que mais quebra pipelines quando muda sem aviso.
- Obrigatoriedade e nulabilidade: quais campos são obrigatórios, quais aceitam nulo e o que um nulo significa naquele contexto.
- Semântica de cada campo: o significado real do dado.
valor_totalestá em reais ou centavos? Já inclui frete? A semântica é o que uma coluna renomeada não carrega junto. - Regras e restrições: valores permitidos, faixas válidas, unicidade, integridade referencial. Por exemplo,
valor_totalsempre maior que zero,moedarestrita aBRL. - Frequência e SLA de atualização: de quanto em quanto tempo o dado é atualizado, qual o atraso máximo aceitável (frescor) e qual a disponibilidade prometida.
- Propriedade e responsabilidades: quem é o dono do dado, quem mantém o contrato e quem aciona quando algo quebra.
- Política de versionamento: como as versões são numeradas (versionamento semântico é comum) e o que caracteriza uma mudança maior ou menor.
- Compatibilidade: quais mudanças preservam a leitura pelos consumidores atuais e quais exigem coordenação.
- Processo de mudança e descontinuação: como uma alteração é proposta, revisada e comunicada, e por quanto tempo uma versão antiga continua no ar antes de ser aposentada.
Perceba que o schema é apenas o começo. Grande parte do valor de um contrato está nas camadas que um arquivo de schema puro não expressa: semântica, SLA, propriedade e o processo de mudar sem quebrar. É por isso que um contrato de dados vai além de uma validação isolada de schema.
O que um contrato de dados não é
Contrato de dados costuma ser confundido com práticas vizinhas, e essa confusão leva a expectativas erradas. Um contrato define proativamente o que deveria ser verdade sobre um dado, antes de ele fluir. As práticas a seguir são complementares, não substitutas, e cada uma resolve uma parte diferente do problema.
O contrato não é um teste de qualidade de dados. O teste é a execução que confere se os dados reais obedecem às regras; o contrato é o acordo declarativo que essas regras traduzem. Na prática, o contrato pode gerar os testes: as regras de qualidade que você declara no YAML viram checagens que rodam no pipeline.
O contrato não é um schema registry. Um registry como o da Confluent armazena e versiona schemas de eventos e impõe regras de compatibilidade em streams. Ele é o mecanismo técnico que aplica uma parte do contrato, o schema, mas não cobre semântica, SLA nem propriedade.
O contrato também não se confunde com observabilidade, linhagem, documentação ou catálogo. A observabilidade monitora e alerta de forma reativa sobre a saúde dos dados em produção. A linhagem mapeia de onde os dados vêm e para onde vão. A documentação e o catálogo descrevem os dados para descoberta humana. O contrato se distingue de todos por ser executável e acionável por ferramentas, e por definir a interface antes de o problema acontecer. A tabela abaixo posiciona as quatro práticas que mais se misturam com contratos.
| Prática | O que faz | Quando age | Relação com o contrato |
|---|---|---|---|
| Contrato de dados | Define o acordo de interface: schema, semântica, qualidade, SLA e propriedade | Antes de o dado fluir (proativo) | É a fonte da verdade que as outras práticas aplicam |
| Teste de qualidade | Verifica se o conteúdo dos dados obedece às regras (nulos, duplicados, faixas) | Após a ingestão ou o build | Executa as regras declaradas no contrato |
| Observabilidade | Monitora e alerta sobre frescor, volume e anomalias em produção | Depois do fato, de forma reativa | Detecta violações que escaparam ao contrato |
| Linhagem | Mapeia dependências entre datasets, origem e destino | Na análise de impacto | Mostra quem depende de cada contrato |
Nenhuma dessas práticas resolve o problema sozinha. O contrato dá a intenção, os testes verificam o conteúdo, a observabilidade vigia a produção e a linhagem mostra o raio de impacto. Juntas, elas formam a espinha da confiabilidade de dados.
Um exemplo prático de contrato de dados
Um contrato não precisa ser complexo para ser útil. O exemplo abaixo descreve uma tabela de pedidos confirmados, no estilo do Open Data Contract Standard, simplificado para leitura. Ele é um arquivo de texto que vive no Git, ao lado do código que produz a tabela.
apiVersion: v3.0.0                # Open Data Contract Standard
kind: DataContract
id: pedidos-confirmados
info:
  title: Pedidos confirmados
  version: 1.3.0                  # versionamento semântico
  owner: time-vendas             # produtor responsável pelo dado
  status: active
  description: Um registro por pedido com pagamento aprovado.

servers:
  - type: bigquery
    dataset: vendas
    table: pedidos_confirmados

schema:
  - name: pedido_id
    logicalType: string
    required: true
    unique: true
    description: Identificador único do pedido.
  - name: cliente_id
    logicalType: string
    required: true
    description: Chave estrangeira para clientes.dim_cliente.
  - name: valor_total
    logicalType: number
    required: true
    description: Valor final em reais, com descontos aplicados. Sempre maior que zero.
  - name: moeda
    logicalType: string
    required: true
    allowedValues: ["BRL"]
  - name: status_pagamento
    logicalType: string
    required: true
    allowedValues: ["aprovado"]
  - name: criado_em
    logicalType: timestamp
    required: true
    description: Data e hora da confirmacao, em UTC.

quality:
  - rule: valor_total_positivo
    description: valor_total deve ser maior que zero
    dimension: validity
  - rule: pedido_id_unico
    description: pedido_id nao se repete
    dimension: uniqueness

sla:
  frequency: hourly              # atualizado de hora em hora
  freshness: 90m                 # atraso maximo de 90 minutos
  availability: 99.5%

terms:
  versioning: semver
  deprecation: 90d               # versao antiga mantida por 90 dias apos aviso
O que torna esse arquivo poderoso é ele ser legível por máquina. A seção schema alimenta a validação de estrutura na ingestão. A seção quality vira testes automáticos. O sla alimenta o monitoramento de frescor. E os terms definem a regra do jogo quando alguém precisa mudar algo. O mesmo documento serve de documentação para humanos e de configuração para as ferramentas.
Onde validar o contrato no pipeline
Um contrato só protege o pipeline se for verificado nos pontos certos. Validar apenas na ingestão deixa escapar mudanças que já custaram trabalho a jusante; validar só no fim atrasa a descoberta do problema. A prática mais robusta distribui a verificação ao longo de todo o fluxo, do desenvolvimento à produção.
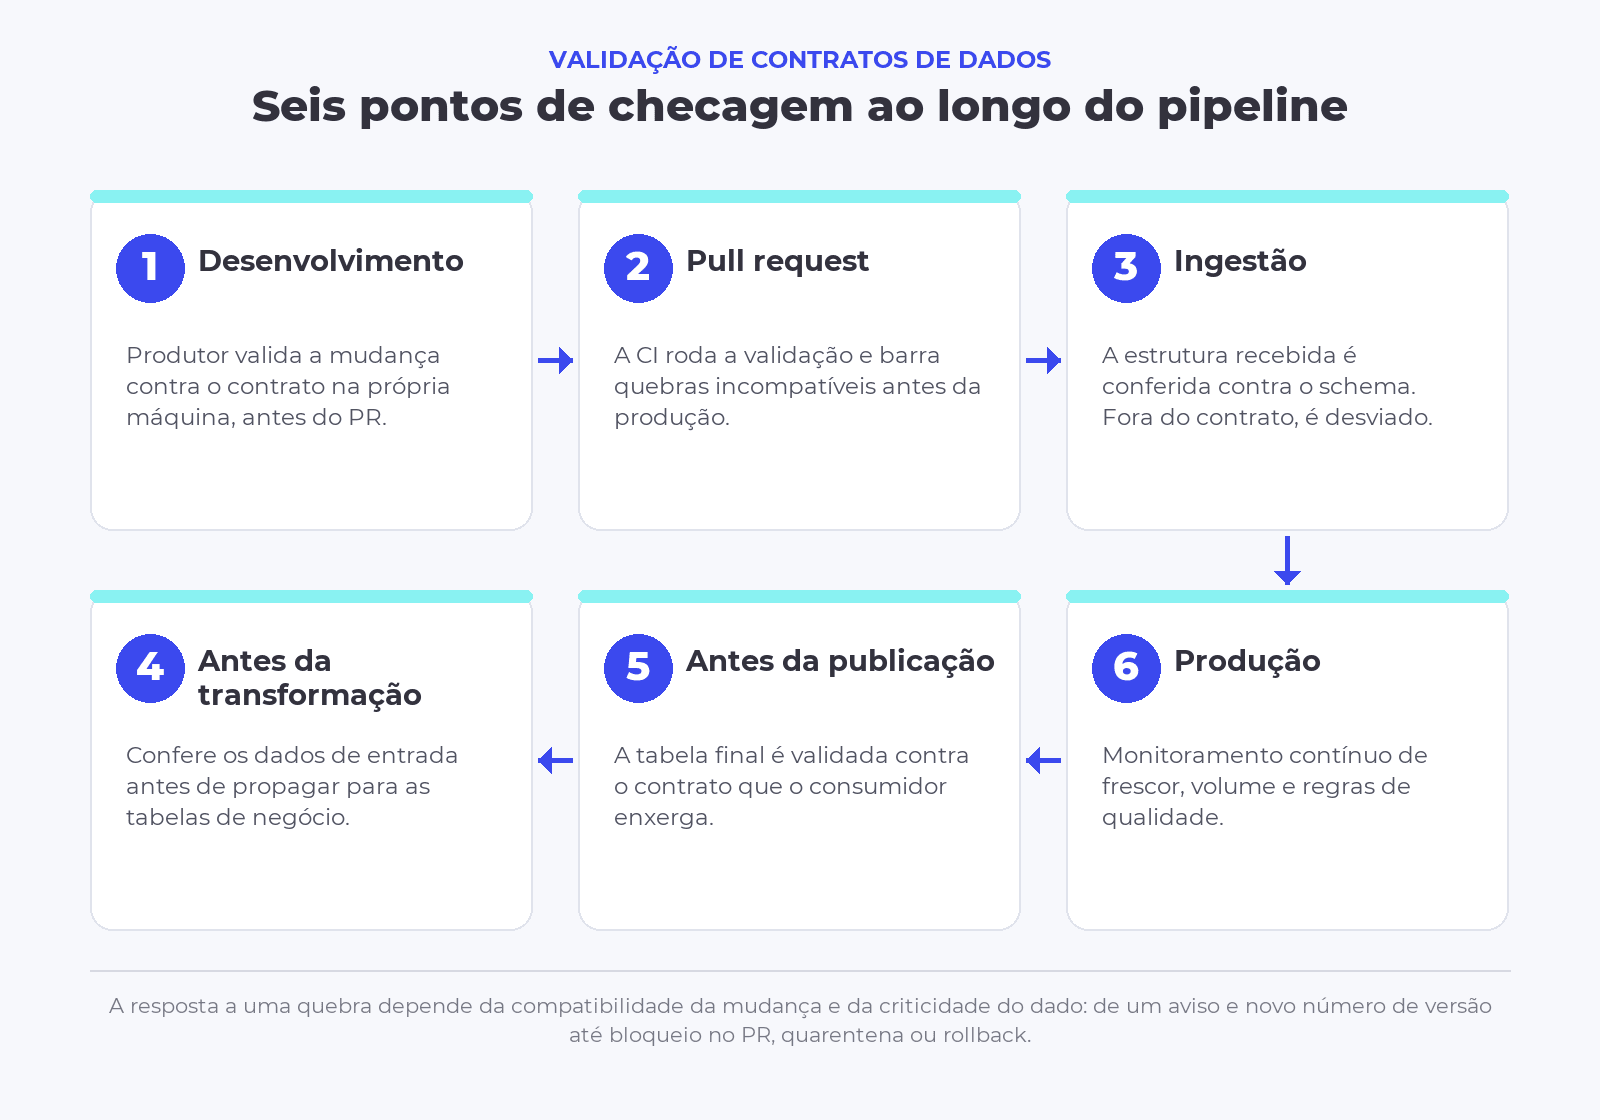 Os seis pontos onde um contrato de dados pode ser validado ao longo do pipeline. Fonte: BIX Tecnologia.
- Durante o desenvolvimento: o produtor valida a mudança contra o contrato na própria máquina, antes de abrir um pull request, com um comando de linha de comando ou um linter.
- No pull request: a integração contínua roda a validação automaticamente e sinaliza se a alteração fere o contrato vigente. É aqui que uma quebra incompatível deveria ser barrada antes de chegar perto da produção.
- Na ingestão: quando o dado entra na plataforma, a estrutura recebida é conferida contra o schema declarado. Registros ou lotes que não batem podem ser rejeitados ou desviados.
- Antes da transformação: entre a camada bruta e a modelada, o pipeline confirma que os dados de entrada respeitam o contrato, evitando propagar lixo para as tabelas de negócio.
- Antes da publicação para consumidores: a tabela final é validada contra o contrato que os consumidores enxergam, garantindo que o que sai obedece ao prometido.
- Durante a execução em produção: monitoramento contínuo de frescor, volume e regras de qualidade, para capturar desvios que só aparecem com dados reais ao longo do tempo.
Ferramentas de orquestração ajudam a posicionar essas checagens no lugar certo do grafo de tarefas. Um pipeline que já usa o Apache Airflow, por exemplo, pode inserir a validação como uma tarefa que bloqueia a transformação seguinte se o contrato não for cumprido, um padrão próximo ao que se descreve em integrar o Airflow com OpenLineage para rastreabilidade dos dados que passam por cada etapa.
O que fazer quando o produtor rompe o contrato
Nem toda quebra de contrato deve derrubar o pipeline. Essa é a decisão mais importante e a mais mal calibrada. A resposta certa depende de dois fatores: se a mudança é compatível ou incompatível com os consumidores atuais, e o quão crítico é o dado para quem depende dele. Tratar toda alteração como emergência gera fadiga de alerta; ignorar as perigosas gera o dashboard zerado da segunda-feira.
A compatibilidade tem regras conhecidas, herdadas da evolução de schemas. A documentação da Confluent sobre compatibilidade de schemas formaliza tipos como backward e forward: em modo backward, o padrão do registry, é seguro remover campos e adicionar campos opcionais com valor default, porque um consumidor com o schema novo ainda lê o dado antigo. Formatos como Avro e Protobuf seguem a mesma lógica. No Avro, adicionar um campo com default é seguro e renomear exige declarar um alias; no Protobuf, os números dos campos são imutáveis e um campo removido deve ir para a lista reserved, para que seu número nunca seja reutilizado. A matriz abaixo traduz isso em respostas práticas.
| Tipo de mudança | Exemplo | Compatibilidade | Resposta recomendada |
|---|---|---|---|
| Adicionar campo opcional com default | Nova coluna canal_venda que aceita nulo | Compatível | Liberar, incrementar versão MINOR, avisar consumidores |
| Adicionar campo obrigatório | Nova coluna imposto sem default | Incompatível | Bloquear no PR, exigir versão MAJOR e prazo de migração |
| Remover ou renomear coluna | valor vira valor_total | Incompatível | Bloquear, manter versão antiga e depreciar com prazo |
| Mudar o tipo de uma coluna | valor_total de string para número | Incompatível | Bloquear, migração coordenada entre produtor e consumidores |
| Mudar a semântica sem mudar o tipo | valor_total passa a incluir frete | Incompatível e silenciosa | Bloquear e comunicar; é a mudança mais perigosa |
| Estreitar uma regra de qualidade | Faixa de valores mais restrita | Depende | Colocar em quarentena os registros fora da nova regra |
Com a compatibilidade classificada, a resposta se organiza em um repertório de ações graduais. Uma mudança compatível pede apenas aviso e o incremento de versão. Uma mudança incompatível em dado crítico justifica bloqueio da alteração no pull request. Dados que chegam fora do contrato podem ir para quarentena, isolados em uma área de staging para inspeção, em vez de contaminar as tabelas de negócio. Em casos graves, uma interrupção controlada do pipeline evita publicar dado errado, e um rollback volta para a última versão boa. Quando a mudança é inevitável, o caminho é manter as duas versões em paralelo por um tempo, comunicar os consumidores afetados e dar um prazo de migração antes de aposentar a versão antiga.
A régua que amarra tudo é a criticidade. Uma coluna que alimenta o fechamento contábil merece bloqueio duro; um campo experimental usado por um único painel interno tolera um aviso. Calibrar a resposta ao impacto real é o que separa um contrato que protege de um contrato que só incomoda. Esse cuidado é o oposto do erro mais comum em projetos de engenharia de dados, que é tratar sintomas isolados em vez da confiabilidade como arquitetura.
Como implementar contratos de dados sem uma nova plataforma
A melhor notícia sobre contratos de dados é que dá para começar com o que você já tem. Não é preciso comprar uma ferramenta dedicada para colher a maior parte do benefício. A implementação evolui em camadas, cada uma reaproveitando uma peça do stack existente.
A base é a definição do contrato como arquivo de texto. Um YAML, um JSON Schema, um schema Avro ou um .proto do Protobuf descrevem a estrutura e as regras. JSON Schema, na versão 2020-12, valida documentos JSON de forma declarativa e é uma escolha natural para payloads. O arquivo entra no Git, ao lado do código do produtor, o que dá versionamento, histórico e revisão de graça.
A partir daí, o fluxo de mudança usa práticas de software que o time já domina. Toda alteração no contrato passa por um pull request, revisado por produtor e consumidores. A CI/CD roda a validação a cada mudança e barra o que fere a compatibilidade. Para quem usa dbt, dois recursos se encaixam direto: os testes do dbt, como not_null, unique, accepted_values e relationships, verificam o conteúdo, enquanto os contratos de modelo do dbt garantem a forma: com contract: enforced: true, o build falha se as colunas e os tipos entregues não baterem com o declarado.
As camadas seguintes plugam nas ferramentas de execução e de operação. Frameworks de qualidade que a empresa talvez já use, como Great Expectations e Soda, funcionam como o motor que roda os checks derivados do contrato dentro do pipeline. A orquestração, com Apache Airflow ou equivalente, posiciona as validações como tarefas que bloqueiam etapas seguintes. Os catálogos e a documentação existentes ganham o contrato como fonte de verdade, e os alertas e a observabilidade já configurados passam a vigiar o SLA declarado. O checklist a seguir organiza esse caminho progressivo.
- Escreva o primeiro contrato em YAML ou JSON Schema para um único dataset crítico, sem tentar cobrir tudo de uma vez.
- Versione o arquivo no Git, no mesmo repositório do código que produz o dado.
- Exija pull request e revisão para qualquer mudança no contrato, com produtor e consumidores como revisores.
- Adicione uma etapa de validação na CI que rode a cada alteração e barre quebras incompatíveis.
- Traduza as regras de qualidade do contrato em testes automáticos com a ferramenta que você já usa (dbt, Great Expectations, Soda).
- Insira a validação de schema na ingestão e antes da transformação, dentro do orquestrador.
- Defina o SLA de frescor e disponibilidade no monitoramento que já existe.
- Documente a política de versionamento, compatibilidade e deprecação, e combine os prazos de migração.
A distribuição de responsabilidades fecha o desenho. Um contrato sem donos claros vira burocracia ignorada. A tabela abaixo resume quem faz o quê.
| Papel | Responsabilidades |
|---|---|
| Produtor (dono do dado) | Escreve e versiona o contrato, não muda sem aviso, comunica deprecações e cumpre o SLA declarado |
| Consumidor | Declara sua dependência, valida contra o contrato, participa da revisão e migra dentro do prazo acordado |
| Time de plataforma e engenharia | Fornece o mecanismo de validação e CI, padroniza o formato do contrato, mantém o registro e monitora o cumprimento |
Começar simples é a estratégia que funciona. Um contrato para o dataset mais crítico, versionado no Git e validado na CI, já elimina a classe de problema mais comum, a mudança de schema sem aviso. As camadas de qualidade, quarentena e observabilidade entram depois, à medida que a prática amadurece, sempre calibradas pela criticidade de cada dado. Contratos de dados não substituem testes, observabilidade ou linhagem: eles dão a esses esforços um ponto de acordo comum, e é essa combinação que sustenta pipelines confiáveis e um acesso à informação em que a empresa pode confiar.
Se a sua operação convive com quebras de schema que derrubam pipelines e mina a confiança nos dados, nossos especialistas podem ajudar a estruturar contratos de dados e a arquitetura de confiabilidade certa para o seu contexto. A BIX trabalha com múltiplas soluções de engenharia de dados, nuvem e governança, e o desenho ideal varia conforme a realidade de cada operação. Fale com a nossa equipe e avance na maturidade dos seus dados. ⬇️
O que são contratos de dados? Contratos de dados são acordos versionados e legíveis por máquina, normalmente em YAML ou JSON, que definem o que um produtor de dados promete entregar: schema, tipos, semântica, regras de qualidade, SLA de atualização e propriedade. Eles funcionam como uma API para dados, permitindo que consumidores dependam de uma interface estável em vez de uma tabela que pode mudar sem aviso.
Qual a diferença entre um contrato de dados e um teste de qualidade? O contrato é o acordo declarativo sobre o que os dados deveriam ser; o teste é a execução que verifica se os dados reais obedecem a esse acordo. Na prática, o contrato é a fonte da verdade e as regras de qualidade que ele declara viram os testes automáticos que rodam no pipeline, como checagens de nulos, duplicados e faixas de valores.
Como implementar contratos de dados sem comprar uma plataforma nova? Comece com um arquivo YAML ou JSON Schema versionado no Git para um dataset crítico. Exija pull request e revisão para mudanças, valide na CI/CD, traduza as regras em testes com uma ferramenta que já usa (dbt, Great Expectations, Soda) e posicione as checagens no orquestrador, como o Airflow. A maior parte do valor vem de processo e ferramentas existentes.
O que acontece quando um produtor quebra o contrato de dados? Depende da compatibilidade da mudança e da criticidade do dado. Mudanças compatíveis, como adicionar um campo opcional, pedem apenas aviso e novo número de versão. Mudanças incompatíveis em dados críticos, como remover uma coluna, devem ser bloqueadas no pull request, com a versão antiga mantida por um prazo de migração. Nem toda quebra deve derrubar o pipeline.
Contrato de dados é o mesmo que schema registry? Não. Um schema registry, como o da Confluent, armazena e versiona schemas de eventos e impõe regras de compatibilidade em streams. Ele aplica uma parte do contrato, o schema, mas não cobre semântica, SLA, propriedade nem processo de mudança. O contrato de dados é mais amplo e o registry pode ser um dos mecanismos que o tornam executável.