Um model registry é o catálogo central onde cada modelo treinado entra com nome, número de versão e os metadados que explicam como ele foi produzido. Ele guarda bem mais do que o arquivo serializado: a execução de treino que originou aquela versão, as métricas de validação, a assinatura de entrada e saída, as etiquetas de status e a referência que diz qual versão está atendendo tráfego neste momento.
A pergunta que justifica a camada inteira aparece quando algo dá errado em produção. Um cliente contesta uma recusa de crédito, o time de risco pede a memória de cálculo, e alguém precisa dizer qual versão gerou aquela predição, com quais dados ela foi treinada e quem aprovou a subida. Sem registry, a resposta depende da lembrança de quem fez o deploy e do nome do arquivo no bucket. Com registry, a resposta é uma consulta.
Este guia abre a camada que a arquitetura de MLOps resolve em um bloco só. Ele cobre o que o registry armazena, como funciona o fluxo de promoção de staging até produção depois que os estágios fixos foram aposentados, e como essa camada se conecta ao retreino disparado por drift.
O que um model registry guarda além do binário do modelo
A unidade de trabalho do registry é o modelo registrado, um nome estável, e abaixo dele as versões, numeradas automaticamente a cada novo registro. A primeira entrada vira a versão 1, a seguinte vira a versão 2, e nenhuma delas é sobrescrita. Esse detalhe é o que torna o rollback trivial: a versão anterior continua íntegra, pronta para voltar a servir.
Cada versão carrega um conjunto de metadados que responde perguntas diferentes. A documentação do MLflow lista, entre os campos de uma versão, o run_id e o source que apontam para a execução de treino, além de creation_timestamp, description, status e user_id. É esse vínculo com a execução que amarra o modelo ao código, ao conjunto de dados e às métricas registradas no experimento.
| O que a versão guarda | O que é | Para que serve na operação |
|---|---|---|
| Nome e número da versão | Identificador estável mais o contador incremental | Referenciar o modelo sem depender de caminho de arquivo |
| Vínculo com a execução de treino | run_id e source apontando para o experimento | Reproduzir o treino e recuperar hiperparâmetros e código |
| Métricas de validação | Resultado do modelo no conjunto de avaliação | Comparar candidato e modelo atual antes de promover |
| Referência do dataset | Versão dos dados usada no treino, registrada como artefato ou linhagem | Auditar sobre quais dados a decisão foi tomada |
| Assinatura | Esquema de entrada, saída e parâmetros | Rejeitar requisição inválida antes de gerar predição errada |
| Tags | Pares chave-valor livres, como validation_status: passed | Registrar o estado da revisão sem travar o fluxo |
| Alias | Referência mutável que aponta para uma versão | Trocar o modelo em produção sem mexer no código de inferência |
A assinatura merece atenção separada porque ela é a única parte do registro que age em tempo de execução. O MLflow a define como o contrato que especifica exatamente quais dados o modelo espera e o que ele devolve, e aplica validação automática ao carregar o modelo, ao usar as ferramentas de deploy e ao servir pela API REST. Campos obrigatórios ausentes derrubam a chamada, campos extras são ignorados e conversões seguras de tipo são aplicadas quando possível. No Databricks, a exigência é explícita: novas versões de modelo no Unity Catalog precisam ter assinatura, justamente porque ela alimenta a validação de entrada e a integração com o Model Serving.
O que separa um registry de uma pasta compartilhada no storage são esses metadados e as regras de acesso em volta deles. No Unity Catalog, por exemplo, modelos registrados são um subtipo do objeto protegível FUNCTION, com privilégios próprios de CREATE MODEL, CREATE MODEL VERSION e EXECUTE. A mesma disciplina de governança de dados que a operação já aplica a tabelas passa a valer para modelos.
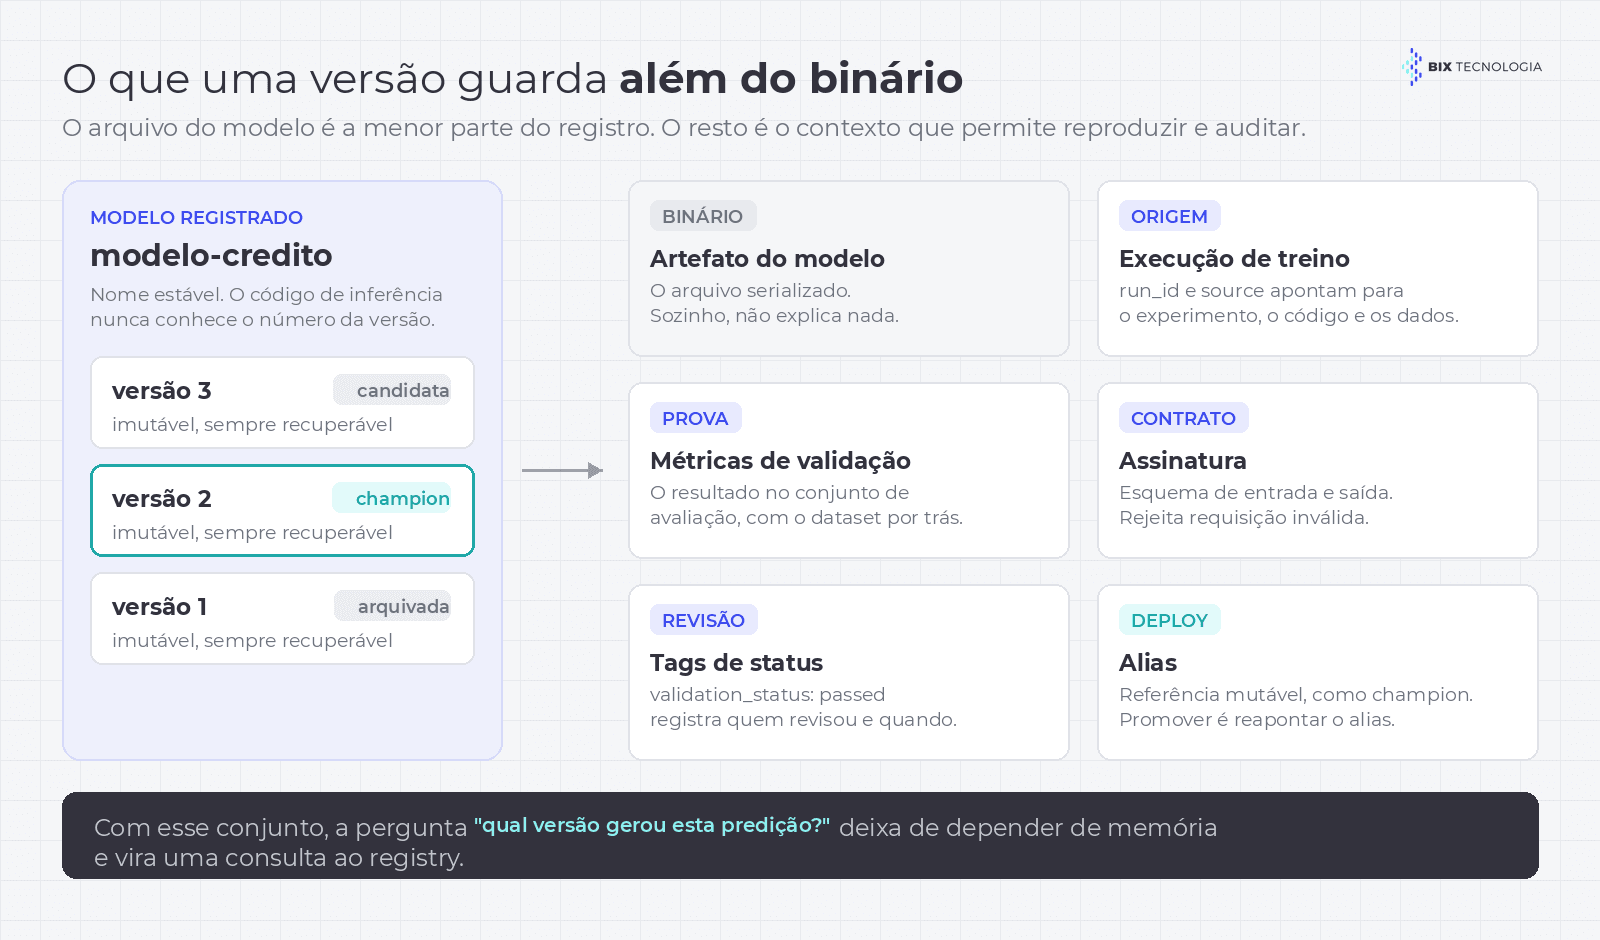
Uma versão no registry é o binário mais o contexto que permite reproduzir, validar e auditar aquele modelo depois.
Do staging à produção: como funciona o fluxo de promoção
Durante anos, o fluxo padrão movia cada versão por quatro estágios fixos: nenhum, staging, produção e arquivado. Esse desenho envelheceu por ser rígido demais para os fluxos reais de MLOps, e a mudança já está na documentação. A partir da versão 2.9.0, o MLflow descontinuou os estágios de modelo e passou a recomendar a combinação de tags e aliases no lugar deles, com remoção prevista para uma versão maior futura.
A substituição funciona em duas peças. As tags de versão registram o estado da revisão, como validation_status: pending enquanto o candidato está em avaliação e validation_status: passed depois que ele cruza a porta. Os aliases criam referências nomeadas e mutáveis para uma versão específica, no padrão models:/<nome>@<alias>, e a convenção mais usada chama de champion a versão que atende a maior parte do tráfego. Como uma mesma versão aceita mais de um alias, testes A/B e liberações graduais deixam de exigir gambiarra de nomenclatura.
O ganho prático é que o código de inferência para de conhecer números de versão. O serviço carrega models:/modelo-credito@champion, e a promoção vira uma chamada de set_registered_model_alias que reaponta o alias. A documentação do MLflow sobre o registry descreve esse fluxo junto com copy_model_version, usado para copiar uma versão entre modelos registrados de ambientes diferentes, por exemplo de dev.time_ml.modelo para prod.time_ml.modelo.
Cada plataforma resolve a mesma promoção com um vocabulário próprio, e vale conhecer o mapeamento antes de escolher onde a camada vai morar.
| Plataforma | Como organiza | Como promove | Ponto de atenção |
|---|---|---|---|
| MLflow (aberto) | Modelo registrado com versões numeradas | Tags de validação mais aliases como champion | Estágios descontinuados na 2.9.0, migração fica com o time |
| Databricks Unity Catalog | Três níveis, catálogo.esquema.modelo | Ambiente pelo catálogo mais alias de deploy | Estágios não são suportados, assinatura é obrigatória |
| Amazon SageMaker | Grupos de pacotes de modelo com versões | Campo ModelApprovalStatus disparando CI/CD | Aprovação é o gatilho, então a esteira precisa existir |
| Azure Machine Learning | Registro central desacoplado dos workspaces | Publicar no registro e implantar em outro workspace | Pensado para promover entre dev, teste e produção |
| Vertex AI | Modelo com versões e aliases, incluindo o alias padrão | Reapontar alias e implantar no endpoint | Avaliação e deploy ficam no mesmo painel do registro |
O SageMaker mostra bem como a promoção vira automação. A documentação da AWS descreve que uma versão registrada nasce com ModelApprovalStatus em PendingManualApproval e que a mudança desse status para Approved inicia o deploy de CI/CD nos templates de projeto da plataforma. Passar para Rejected não dispara ação, e voltar de Approved para Rejected faz a esteira implantar a última versão ainda aprovada, que é o rollback automatizado.
A porta de promoção é o que separa registry de depósito de arquivos
Um registry sem regra de promoção repete o problema que ele deveria resolver. Qualquer versão chega à produção sem revisão, ninguém consegue dizer por que aquela subiu, e a rastreabilidade se perde exatamente no ponto em que ela importaria. A porta de promoção é o conjunto mínimo de condições que um candidato precisa satisfazer para receber o alias de produção.
Na prática, essa porta costuma ter quatro condições encadeadas. O candidato supera o modelo atual na métrica de negócio dentro do mesmo conjunto de validação. A assinatura confere com o contrato que a camada de serving publica. As tags de validação estão preenchidas por quem revisou. E existe registro de quem autorizou, seja pela trilha de aprovação do CI/CD, seja pelo próprio campo de status do registry.
Como responder "qual versão gerou esta predição"
Registrar o modelo resolve metade da rastreabilidade. A outra metade depende de gravar, a cada inferência, qual versão respondeu. Sem esse registro do lado do serving, a operação sabe quais versões existiram e continua sem saber qual delas produziu o número que o cliente está contestando.
As plataformas de serving resolvem isso com log automático de requisições. No Databricks, as tabelas de inferência gravam requisições e respostas do endpoint em tabelas Delta no Unity Catalog, e o esquema traz databricks_request_id, timestamp_ms, request, response, status_code, execution_time_ms e um campo request_metadata que, segundo a documentação de inference tables, contém o nome do endpoint, o nome do modelo e a versão do modelo. É esse último campo que fecha a cadeia entre a predição individual e a entrada correspondente no registry.
Com a predição carimbada pela versão, três coisas passam a ser possíveis. A auditoria reconstrói o caminho completo, da predição para a versão, da versão para a execução de treino e dela para o dataset. A comparação entre versões deixa de ser teórica, porque o time consegue separar o desempenho real de cada uma no mesmo período. E o monitoramento ganha a chave de junção que faltava para cruzar predições com os rótulos que chegam depois.
Esse cruzamento é o que liga o registry ao ciclo de correção. O monitoramento de drift de modelo compara a janela de produção com a janela de referência do treino, e a janela de referência só existe porque o registry guardou qual dataset gerou a versão em uso. Quando o alerta se confirma e o retreino produz um candidato, ele volta para o registry como uma nova versão, passa pela porta de validação e recebe o alias de produção caso supere o modelo atual. O loop fecha sobre a mesma camada que o abriu, e a escolha entre servir esse modelo em batch ou por endpoint online determina apenas como o alias é consumido.
Três erros derrubam esse desenho com frequência. Registrar o modelo sem registrar a versão dos dados deixa a métrica sem contexto e torna a reprodução impossível. Manter o código de inferência preso ao número da versão transforma cada promoção em deploy de aplicação, que é justamente o trabalho manual que o alias elimina. E tratar o registry como destino final do pipeline de treino ignora metade da função dele, porque ele precisa ser também a origem do pipeline de deploy, alimentado por features consistentes vindas de uma feature store e por um processo de treino já preparado para produção, como o descrito no tutorial de modelo no Databricks.
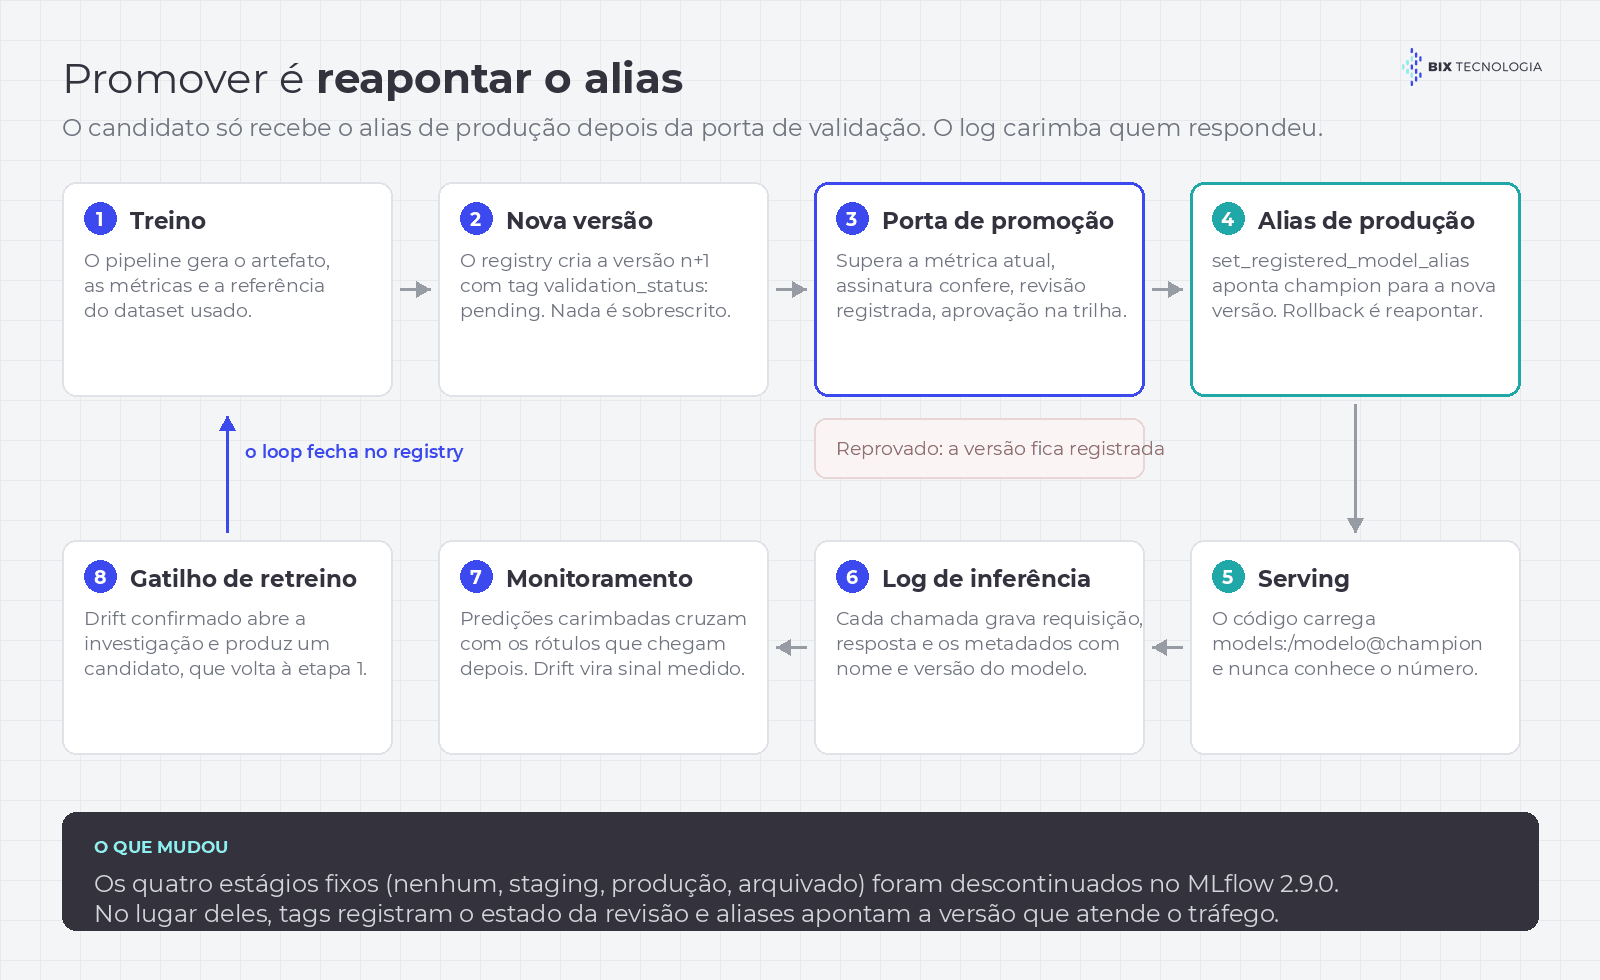
Do candidato ao alias de produção: a promoção troca a referência, e o log de inferência grava qual versão respondeu cada chamada.
O model registry é a camada que transforma um conjunto de arquivos de modelo em um histórico auditável de decisões. Ele custa pouco para começar, porque as ferramentas abertas e as gerenciadas já entregam o catálogo pronto, e o retorno aparece no primeiro incidente que precisa ser explicado. Um caminho de partida que funciona em quase toda operação: registre todo modelo treinado como versão, grave a referência do dataset junto com as métricas, adote um alias de produção no lugar de número de versão fixo no código e ligue o log de inferência antes de aumentar o volume.
Se a sua empresa tem modelos em produção sem versionamento rastreável, ou quer montar a porta de promoção e o log de inferência que sustentam auditoria, nossos especialistas podem ajudar a desenhar essa camada dentro da sua arquitetura. Fale com a nossa equipe e avance na maturidade dos seus dados.

Perguntas frequentes sobre model registry
O que é um model registry? Um model registry é o catálogo central de modelos de machine learning treinados. Ele guarda cada versão com o vínculo para a execução de treino, as métricas de validação, a referência do dataset, a assinatura de entrada e saída, tags de status e aliases de deploy. Serve para versionar, promover e auditar modelos em produção.
Qual a diferença entre model registry e experiment tracking? O experiment tracking registra todas as tentativas de treino, com parâmetros e métricas de cada rodada, e serve para comparar experimentos. O model registry guarda apenas os modelos promovidos a candidatos, organizados por versão, com estágio ou alias de deploy e regras de acesso. Um alimenta o outro: o experimento gera o artefato que entra no registry.
Como saber qual versão do modelo gerou uma predição? Grave a versão junto com cada inferência. Plataformas de serving fazem isso automaticamente: no Databricks, a tabela de inferência registra requisição e resposta com um campo de metadados que contém nome do endpoint, nome do modelo e versão. Com esse carimbo, a auditoria vai da predição até o dataset de treino.
Os estágios staging e produção do MLflow ainda existem? A partir do MLflow 2.9.0 os estágios de modelo foram descontinuados e serão removidos em uma versão maior futura. A recomendação atual combina tags de versão, que registram o estado da validação, com aliases mutáveis como champion, que apontam para a versão em produção. Modelos no Unity Catalog do Databricks já não suportam estágios.
Quando vale a pena adotar um model registry? Vale a partir do primeiro modelo que sustenta decisão de negócio e precisa ser explicado depois. O custo de adoção é baixo, porque MLflow, SageMaker, Vertex AI e Azure Machine Learning já entregam o catálogo pronto. O custo de não ter aparece no primeiro pedido de auditoria ou no primeiro rollback feito no escuro.